
什么是缓存淘汰策略
我们知道,现代计算机采用多级存储结构。为了加速程序执行,通常会将数据从低速存储提前加载到访问速度更快的高速存储(缓存)中。
但是,由于实际数据量可能远超缓存容量,当有新数据需要进入缓存时,就需要按照一定的规则选择并替换旧数据,这就是所谓的缓存淘汰策略。
维基百科:
缓存文件置换机制(英语:Cache replacement policies)是计算机管理缓存存储器的一种机制。
由于缓存空间有限,无法容纳所有数据,因此当新数据需要进入缓存时,必须根据一定的规则选择合适的数据进行替换,这种规则就称为缓存置换机制。
常见的缓存淘汰策略包括:
- FIFO(First In First Out):先进先出,优先淘汰最早进入缓存的数据,类似队列的思想;
- LRU(Least Recently Used):最近最少使用,优先淘汰距离上次访问时间最久的数据;
- LFU(Least Frequently Used):最不经常使用,优先淘汰访问频率最低的数据。
缓存淘汰策略的一项重要评价指标是缓存命中率。我们希望在有限的缓存容量下,尽可能提高缓存命中率,从而减少对低速存储的访问,加速程序执行。
LRU 和 LFU 的问题
LRU 通常基于哈希表和双向链表实现,每次访问后将对应数据移动到链表头部,并从链表尾部淘汰数据。LRU 实现简单,在多数场景下也能取得不错的效果。
但是,LRU 存在缓存污染的问题。例如,当程序进行一次全量数据扫描时,大量只访问一次的数据可能将原有的热点数据挤出缓存,导致后续访问热点数据时,需要重新从下级存储加载。
LFU 通常可以基于哈希表和小顶堆实现。相比 LRU,LFU 更关注数据的访问频率,能够有效避免一次性扫描造成的缓存污染。
但是,LFU 需要额外维护缓存项的访问频率信息,带来一定的存储和更新开销。此外,由于历史访问频率不断累积,曾经的热点数据即使不再被访问,也可能长期占据缓存空间,难以及时淘汰。
TinyLFU
TinyLFU [1] 是一种用于优化传统 LFU 问题的缓存准入策略(Cache Admission Policy)。与直接决定淘汰哪个数据不同,TinyLFU 在新数据进入缓存时,会比较候选数据(Candidate)和待淘汰数据(Victim)的访问频率,选择频率更高的数据保留在缓存中。
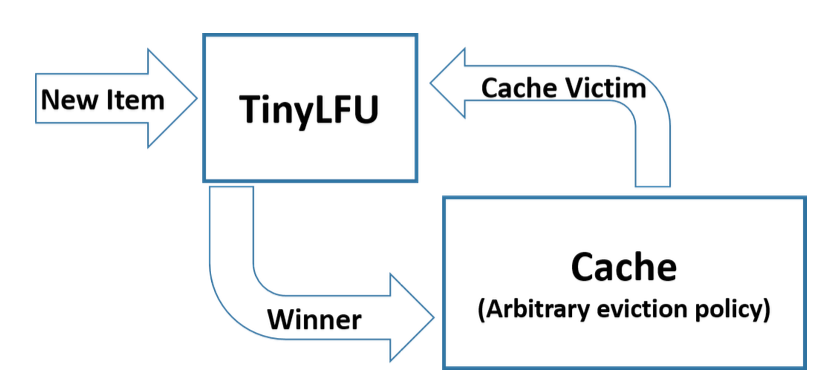
首先,为了解决访问频率统计的存储开销问题,TinyLFU 使用了 Count-Min Sketch(CM-Sketch)。
CM-Sketch 是一种与布隆过滤器类似的概率数据结构,不同之处在于,其数组中的每个位置存储的是计数值。对于一个 Key,通过多个 Hash 函数映射到数组中的不同位置,并将对应计数器加一;查询时,取这些计数器中的最小值作为访问频率的估计值。
需要注意的是,由于存在 Hash 冲突,CM-Sketch 不支持直接删除某个 Key 的统计信息。
为了进一步降低频率统计的存储开销,TinyLFU 认为没有必要无限累积历史访问频率,因此引入了周期性衰减机制。TinyLFU 设置一个采样窗口大小 W,当累计访问次数达到 W 时,通过 Reset 操作将所有计数器的值减半,从而降低历史访问记录的影响,同时限制计数器的增长。
为了更好地适应突发访问和热点变化,在 TinyLFU 的基础上进一步提出了 W-TinyLFU(Window TinyLFU)。如下图所示,W-TinyLFU 将缓存划分为两部分:
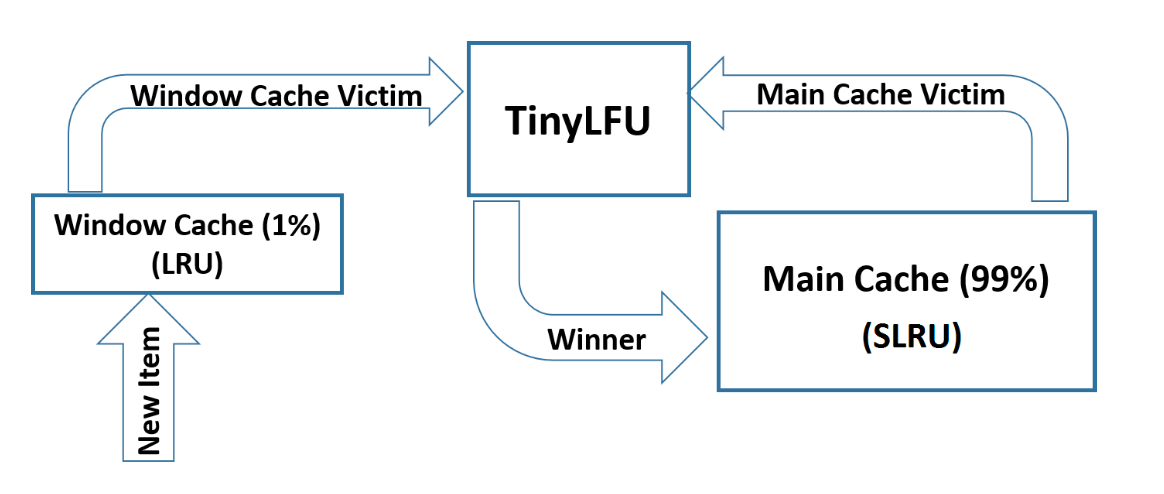
- Main Cache:使用 SLRU [2](分段 LRU)管理缓存数据,并结合 TinyLFU 进行准入判断。SLRU 包含 Protected(保护区)和 Probation(试用区)两部分,分别用于保存访问较频繁和相对较少的数据。
- Window Cache:使用 LRU 淘汰策略,用于缓存新进入的数据,以便快速适应短期热点。
每次写入缓存时,新数据首先进入 Window Cache。当 Window Cache 满时,被淘汰的数据将尝试进入 Main Cache 的 Probation 区域。如果 Main Cache 已满,则使用 TinyLFU 比较候选数据和待淘汰数据的访问频率,频率更高的一方保留在缓存中。
通过这种方式,W-TinyLFU 结合了 LRU 和 LFU 的优点,既能快速适应短期热点,又能避免低频数据对长期热点数据造成缓存污染。
由于 W-TinyLFU 的优异表现,Java 本地缓存框架 Caffeine 采用了该算法。Spring 也支持使用 Caffeine 作为缓存组件。下一篇文章中,我们将进一步介绍 Caffeine 中 W-TinyLFU 的具体实现。
Reference
[1] TinyLFU: A Highly Efficient Cache Admission Policy
[2] Modern LRU